
What is Word2vec and Word Embeddings?
Word2vec and Word Embeddings are two strategies of natural language processing (NLP). Word2vec is a two-layer neural network used to generate distributed representations of words called word embeddings, while word embeddings are a collection of numerical vectors (embeddings) that represent words. Word2vec is a deep learning algorithm that can learn the representations of words by scanning through large amounts of text or text corpora.
How do Word2vec and Word Embeddings Work?
Word2vec and Word Embeddings are based on the idea of distributed representation. This means that each word is represented as a vector of numbers instead of a single number. This allows for words to have similar meaning to have similar vectors. Word2vec uses a neural network to learn these representations, while word embeddings are learned from text corpora.
What are the Differences between Word2vec and Word Embeddings?
The primary difference between Word2vec and Word Embeddings is the way in which they are created. Word2vec is a machine learning algorithm that uses a deep neural network to learn the representations of words by scanning through large amounts of text. Word embeddings are created by analyzing the context of words in text corpora. Additionally, Word2vec is used to generate distributed representations of words, while word embeddings are a collection of numerical vectors.
Why Should You Use Word2vec and Word Embeddings?
Word2vec and Word Embeddings are important tools for natural language processing. They allow for words to be represented in a numerical form, which is useful for many NLP tasks such as text classification, sentiment analysis, and machine translation. Additionally, Word2vec and Word Embeddings can be used to better understand the context of words, which can be useful for many applications such as document summarization and question answering.
Miten käyttää parhaita suuria kielimalleja toimintatutkimukseen Speakin kanssa?

Vaihe 1: Luo Speak-tilisi
Jotta voit aloittaa puhtaaksikirjoituksen ja analyysin, sinun on ensin tehtävä seuraavat toimet luo Speak-tili. Ei hätää, tämä on erittäin helppoa!
Get a 7-day trial with free credits for English audio and video transcription included when you sign up for Speak.
Jos haluat rekisteröityä Speakiin ja aloittaa Speak Magic -kehotteiden käytön, käy osoitteessa Speak app rekisteröintisivu täällä.

Vaihe 2: Lataa toimintatutkimuksen tiedot
Speakissa voit ladata, transkriboida ja kääntää ääni-, video- ja tekstitiedostoja saumattomasti kerralla! Jos sinulla on video, voit käyttää AI video-teksti-muunnin muuntaa videon tekstiksi; jos sinulla on ääntä, voit käyttää meidän AI audio-teksti-muunnin muuntaa äänen tekstiksi. Voit myös transkriboida YouTube-videoita ja käyttää tekoälyä tekstin analysointiin. Näet yhteensopivat tiedostotyypit kullekin vaihtoehdolle alla.
Hyväksytyt äänitiedostotyypit
- MP3
- M4A
- WAV
- OGG
- WEBM
- M4P
Hyväksytyt videotiedostotyypit
- MP4
- M4V
- WMV
- AVI
- MOV
- FLV
Hyväksytyt tekstitiedostotyypit
- TXT
- Word Doc
CSV-tuonnit
Voit myös ladata CSV-tekstitiedostoja tai ääni- ja videotiedostoja. Lisätietoja CSV-latauksista saat ja Lataa Speak-yhteensopivat CSV-tiedostot täältä.
CSV-tiedostojen avulla voit ladata mitä tahansa kymmenistä YouTube-videoista tuhansiin haastattelutietoihin.
Julkisesti saatavilla olevat URL-osoitteet
Voit myös ladata Speakiin mediaa julkisesti saatavilla olevan URL-osoitteen kautta.
Kunhan tiedostotyypin laajennus on saatavilla URL-osoitteen lopussa, tallenteen tuominen automaattista transkriptiota ja analysointia varten ei ole ongelma.
YouTube URL-osoitteet
Speak on yhteensopiva YouTube-videoiden kanssa. Sinun tarvitsee vain kopioida YouTube-videon URL-osoite (esim, https://www.youtube.com/watch?v=qKfcLcHeivc).
Speak etsii tiedoston automaattisesti, laskee pituuden ja tuo videon.
Jos käytät YouTube-videoita, varmista, että käytät koko linkkiä etkä lyhennettyä YouTube-pätkää. Varmista lisäksi, että poistat kanavan nimen URL-osoitteesta.
Puhu integraatiot
Kuten mainittiin, Speak sisältää myös useita integraatioita seuraaviin tarkoituksiin Zoomaus, Zapier, Vimeo ja muut, jotka auttavat sinua automaattisesti transkriboimaan mediasi.
Tämä integraatioiden kirjasto kasvaa jatkuvasti! Onko sinulla pyyntöä? Lähetä meille viesti.

Vaihe 3: Laske ja maksa summa automaattisesti
Once you have your file(s) ready and load it into Speak, it will automatically calculate the total cost (free credits are included in the 7-day trial – take advantage of them!).
Jos lataat tekstidataa Speakiin, sinun ei tällä hetkellä tarvitse maksaa mitään kustannuksia. Ainoastaan Speakin Magic Prompts -analyysi aiheuttaisi maksun, josta kerrotaan tarkemmin jäljempänä.
Once you use your trial credits or need Speak Magic Prompts, you can top up credits (1 credit = US$1) or subscribe to Pro at US$25 per user per month, or US$20 per user per month billed annually. See the hinnoittelusivu lisätietoja varten.
Voit myös lisätä saldoa tai maksaa latauksista ja analyyseistä ilman suunnitelmaa käyttämällä omaa luottokortti.

Vaihe 4: Odota puhetta toimintatutkimustietojesi analysoimiseksi.
Jos lataat ääntä ja videota, automaattinen transkriptioohjelmistomme valmistelee transkriptin nopeasti. Kun se on valmis, saat sähköpostitse ilmoituksen siitä, että opintosuoritusotteesi on valmis. Sähköpostissa on linkki tiedostoon, josta pääset interaktiiviseen mediasoittimeen, jossa on valmiina transkriptio, analyysi ja vientimuodot.
Jos tuot CSV-tiedostoja tai lataat tekstitiedostoja, Speak analysoi tiedot yleensä paljon nopeammin.
Vaihe 5: Käy tiedostossa tai kansiossa
Speak pystyy analysoimaan sekä yksittäisiä tiedostoja että kokonaisia kansioita.
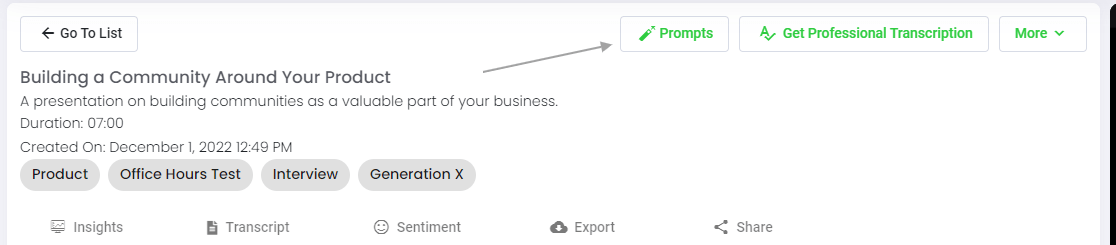
Kun tarkastelet mitä tahansa yksittäistä tiedostoa Speakissa, sinun tarvitsee vain napsauttaa "Kehotukset"-painiketta.
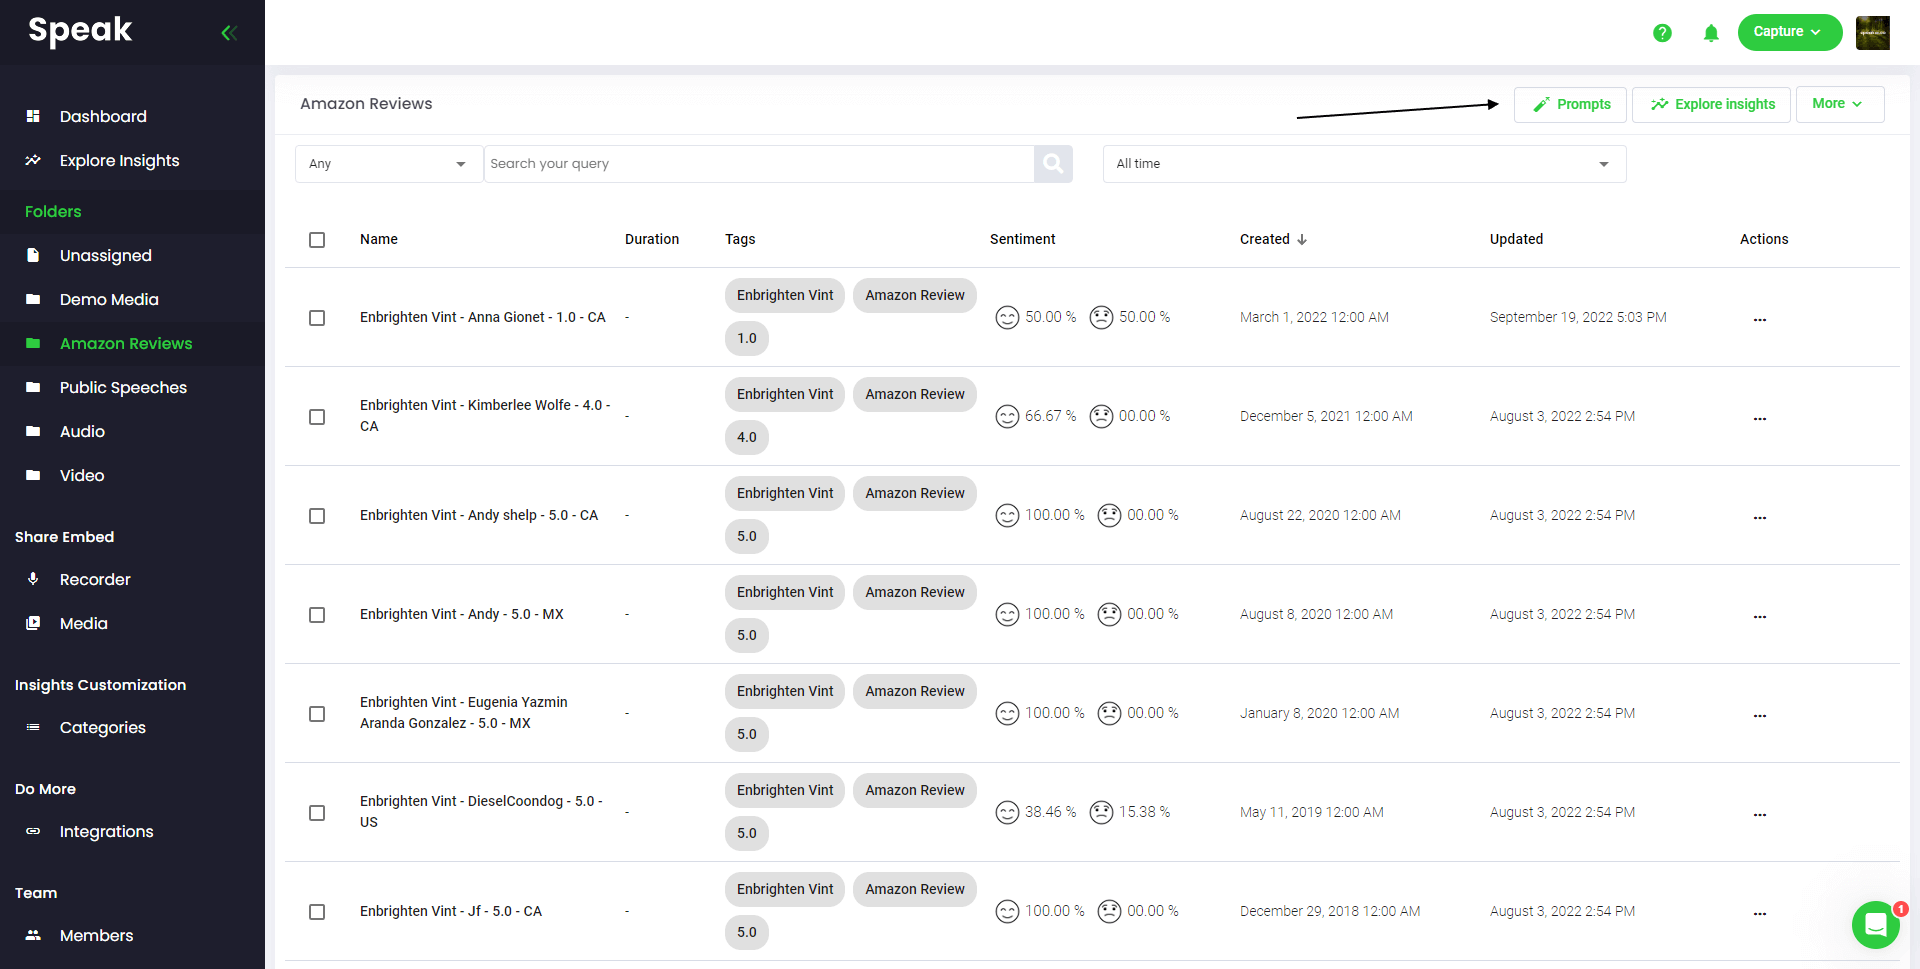
Jos haluat analysoida useita tiedostoja, sinun tarvitsee vain lisätä analysoitavat tiedostot Speakin sisällä olevaan kansioon.
Voit tehdä sen lisäämällä uusia tiedostoja Speakiin tai järjestämällä nykyiset tiedostot haluamaasi kansioon ohjelmiston helpon muokkaustoiminnon avulla.
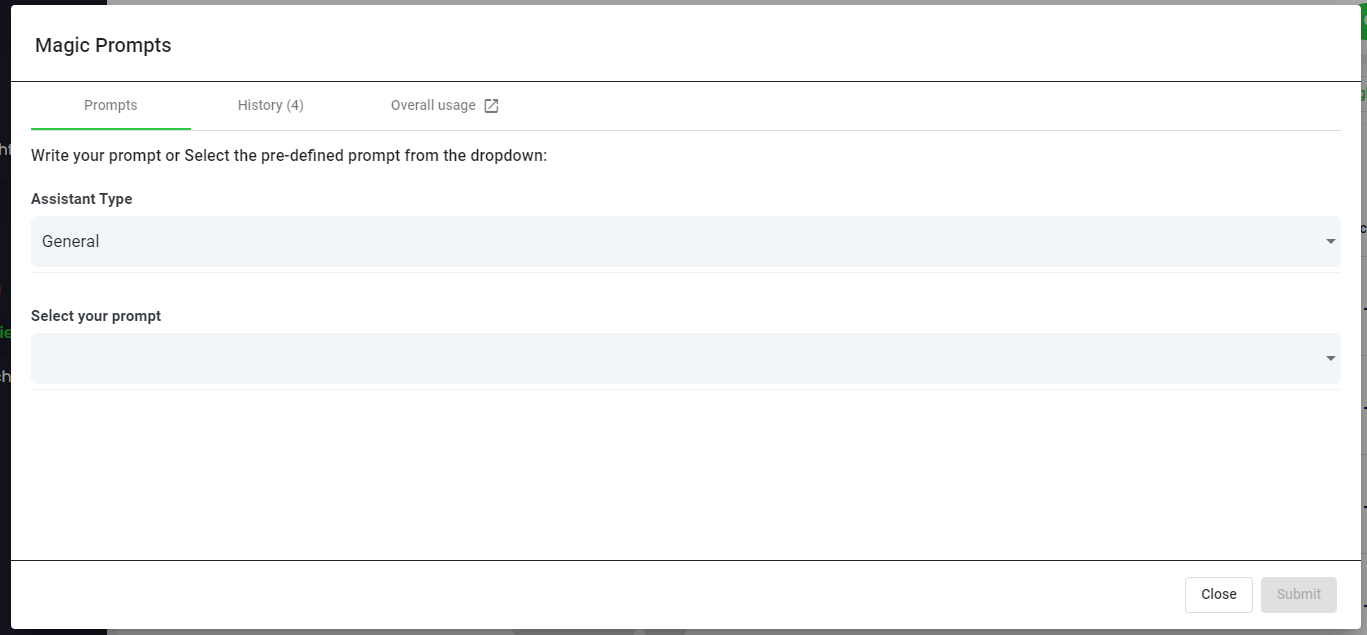
Vaihe 6: Valitse Speak Magic -kehotteet toimintatutkimustietojesi analysointia varten.
Mitä ovat maagiset kehotukset?
Speak Magic Prompts hyödyntää innovaatioita tekoälymalleissa, joita kutsutaan usein "generatiiviseksi tekoälyksi".
Nämä mallit ovat analysoineet valtavia määriä internetistä saatua dataa saadakseen tietoa kielestä.
Tämän ymmärryksen avulla nämä "suuret kielimallit" pystyvät suorittamaan mielettömiä tehtäviä!
Speak Magic Promptsin avulla voit nyt suorittaa nämä tehtävät Speak-tilisi ääni-, video- ja tekstitiedoille.
Vaihe 7: Valitse avustajatyyppi
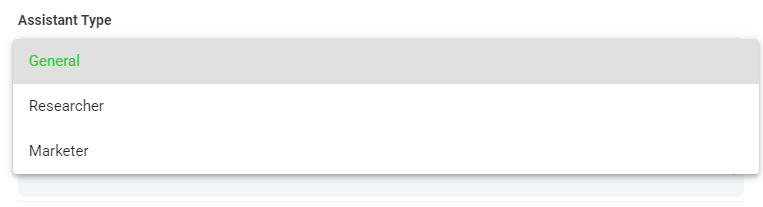
Jotta Speak Magic -kehotteiden avulla saisit parempia tuloksia, Speak on ottanut käyttöön "Assistant Type" -toiminnon.
Nämä avustajatyypit ovat esiasetettuja, ja ne tarjoavat kontekstin kehotusmoottorille, joka tuottaa tiiviimpiä ja merkityksellisempiä tuloksia tarpeidesi mukaan.
Aluksi olemme ottaneet mukaan:
- Yleistä
- Tutkija
- Markkinoija
Valitse pudotusvalikosta sopivin avustajatyyppi.
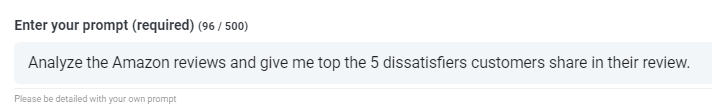
Vaihe 8: Luo tai valitse haluamasi kehote.
Tässä on muutamia esimerkkejä kehotuksista, joita voit soveltaa mihin tahansa tiedostoon juuri nyt:
- Luo SWOT-analyysi
- Anna minulle tärkeimmät toimintakohteet
- Luo luettelon tiivistelmä bullet point -luettelosta
- Kertokaa minulle keskeiset kysymykset, jotka jäivät ratkaisematta...
- Kerro minulle, mitä kysymyksiä esitettiin
- Luo omia mukautettuja kehotuksia
Aukeaa modaali, jonka avulla voit käyttää edellä esittämiämme ehdotettuja kehotuksia saadaksesi vastauksesi välittömästi ja maagisesti.
Jos haluat luoda omia kehotteita, valitse avattavasta valikosta "Mukautettu kehote", jolloin aukeaa toinen tekstiruutu, jossa voit kysyä mitä tahansa haluamasi tietoja!
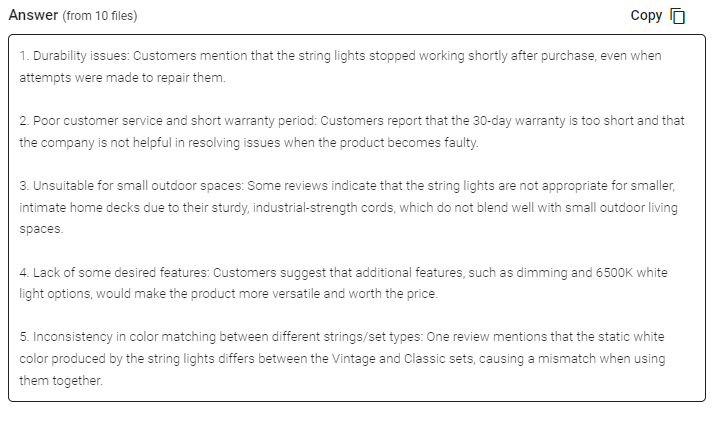
Vaihe 9: Tarkastele ja jaa vastaukset
Speak luo sinulle tiiviin vastauksen tekstiruutuun, joka on kehotteen valintapudotusvalikon alapuolella.
Tässä esimerkissä pyydämme analysoimaan kaikki kansiossa olevat haastattelutiedot kerralla ja etsimään tuotteisiin eniten tyytymättömiä.
Voit helposti kopioida tämän vastauksen esityksiin, sisältöön, sähköposteihin, tiimin jäsenille ja paljon muuta!
Speak Magic -kehotteet ChatGPT:nä toimintatutkimuksen tietojen hinnoittelua varten
Our team at Speak AI continues to optimize the pricing for Magic Prompts and Speak as a whole.
Juuri nyt kaikki Speakin 7 päivän kokeiluversiossa olevat saavat tililleen 100 000 merkkiä.
Jos tarvitset enemmän hahmoja, voit helposti sisällyttää Speak Magic Prompts -komennot suunnitelmaasi, kun luot tilauksen.
Voit myös päivittää tililläsi olevien hahmojen määrää, jos sinulla on jo tilaus.
Molemmat vaihtoehdot ovat käytettävissä tilaussivu.
Vaihtoehtoisesti voit käyttää Speak Magic Prompts by saldon lisääminen tilillesi. Saldoa käytetään, kun analysoit hahmoja.
Muokkaa suunnitelmasi täysin henkilökohtaiseksi 📝
Me täällä Speakissa olemme tehneet tilauksen personoimisen uskomattoman helpoksi.
Kun olet rekisteröitynyt, käy vain meidän mukautetun suunnitelman rakentaja ja valitse haluamasi mediamäärä, tiimin koko ja ominaisuudet, jotta saat tarpeisiisi sopivan paketin.
Ei enää jäykkiä suunnitelmia. Voit päivittää, alentaa tai peruuttaa sopimuksen milloin tahansa.
Lunasta erikoistarjouksesi 🎁
Kun tilaat, saat myös ilmaisen premium-lisäosan kolmeksi kuukaudeksi!
Säästät siis jopa $50 USD kuukaudessa ja yhteensä $150 USD.
Kun olet tilannut suunnitelman, sinun tarvitsee vain lähettää meille live-chat ja alla olevasta luettelosta valitsemasi premium-lisäosa:
- Premium-vientivaihtoehdot (Word, CSV ja muut)
- Mukautetut kategoriat & Insights
- Joukkomuokkaus ja tietojen organisointi
- Tallentimen räätälöinti (brändi, syöttö ja muuta)
- Mediasoittimen mukauttaminen
- Jaettavat mediakirjastot
Laitamme lisäosan tilillesi ilmaiseksi!
Mitä sinä odotat?
Suosittele muita ja ansaitse oikeaa rahaa 💸
Jos sinulla on ystäviä, vertaisia ja seuraajia, jotka ovat kiinnostuneita käyttämään alustaa, voit ansaita todellista kuukausittaista rahaa.
Saat prosenttiosuuden kaikesta myynnistä riippumatta siitä, maksavatko asiakkaat, joita suosittelet maksamaan suunnitelmasta, automaattisesti transkriboimaan mediaa tai hyödyntämään ammattimaisia transkriptiopalveluja.
Käytä tätä linkkiä tullaksesi viralliseksi Speakin tytäryhtiöksi.
Tutustu erikoistuneisiin resursseihimme📚
Varaa ilmainen käyttöönottotilaisuus 🤝
Olisi kunnia saada henkilökohtaisesti hypätä kanssasi esittelypuheluun varmistaaksemme, että olet valmistautunut menestykseen.
Käytä vain Calendly-linkki löytääksesi itsellesi sopivan ajankohdan. Odotamme innolla tapaamista!
Usein kysytyt kysymykset
What is the difference between Word2Vec and word embeddings?
Word embeddings are the general idea of representing words as dense numerical vectors. Word2Vec is one specific algorithm, introduced by Google researchers in 2013, that learns those vectors from large text collections.
How does Word2Vec work?
It trains a shallow neural network in one of two ways. CBOW predicts a word from its surrounding context, while Skip-gram predicts the surrounding words from a target word. The learned weights become the word vectors.
What are contextual word embeddings?
Contextual embeddings give the same word a different vector depending on its sentence. Models such as BERT and GPT do this, so bank in a river sentence differs from bank in a finance sentence. Word2Vec gives one fixed vector per word.
What is the difference between one-hot encoding and word embeddings?
One-hot encoding gives each word a long sparse vector with a single 1 and no sense of meaning. Embeddings are shorter dense vectors where words with similar meanings sit close together.
Analyze Text, Audio & Video with Speak AI
Speak AI provides AI-powered text, audio, and video analysis with NLP, sentiment analysis, keyword extraction, and theme detection. Built for researchers, analysts, and enterprise teams working with qualitative and quantitative data.
 English
 Español
 Français
 Italiano
 العربية
 Português do Brasil
 Nederlands
 Deutsch
 עִבְרִית
 Русский
 日本語
 Polski
 Čeština
 Українська
 Slovenščina
 Svenska
 Ελληνικά
 Norsk bokmål
 简体中文
 Türkçe
 Català
 Magyar
 한국어
 Slovenčina
 Suomi