
What is Word2vec and Word Embeddings?
Word2vec and Word Embeddings are two strategies of natural language processing (NLP). Word2vec is a two-layer neural network used to generate distributed representations of words called word embeddings, while word embeddings are a collection of numerical vectors (embeddings) that represent words. Word2vec is a deep learning algorithm that can learn the representations of words by scanning through large amounts of text or text corpora.
How do Word2vec and Word Embeddings Work?
Word2vec and Word Embeddings are based on the idea of distributed representation. This means that each word is represented as a vector of numbers instead of a single number. This allows for words to have similar meaning to have similar vectors. Word2vec uses a neural network to learn these representations, while word embeddings are learned from text corpora.
What are the Differences between Word2vec and Word Embeddings?
The primary difference between Word2vec and Word Embeddings is the way in which they are created. Word2vec is a machine learning algorithm that uses a deep neural network to learn the representations of words by scanning through large amounts of text. Word embeddings are created by analyzing the context of words in text corpora. Additionally, Word2vec is used to generate distributed representations of words, while word embeddings are a collection of numerical vectors.
Why Should You Use Word2vec and Word Embeddings?
Word2vec and Word Embeddings are important tools for natural language processing. They allow for words to be represented in a numerical form, which is useful for many NLP tasks such as text classification, sentiment analysis, and machine translation. Additionally, Word2vec and Word Embeddings can be used to better understand the context of words, which can be useful for many applications such as document summarization and question answering.
Kako uporabljati najboljše velike jezikovne modele za akcijske raziskave z govorjenjem

Korak 1: Ustvarite svoj račun Speak
Za začetek prepisovanja in analize morate najprej ustvarite račun Speak. Brez skrbi, to je zelo enostavno!
Get a 7-day trial with free credits for English audio and video transcription included when you sign up for Speak.
Če se želite prijaviti na program Speak in začeti uporabljati čarobne namige programa Speak, obiščite Stran za registracijo aplikacije Speak app tukaj.

Korak 2: Naložite podatke o raziskavi akcije
V programu Speak lahko nemoteno nalagate, prepisujete in prevajate zvočne, video in besedilne datoteke naenkrat! Če imate videoposnetek, lahko uporabite naš Pretvornik videoposnetkov AI v besedilo za pretvorbo videoposnetka v besedilo; če imate zvok, lahko uporabite naš Pretvornik zvoka v besedilo AI za pretvorbo zvoka v besedilo. Prav tako lahko prepisovanje videoposnetkov YouTube in . uporaba umetne inteligence za analizo besedila. V nadaljevanju si lahko ogledate združljive vrste datotek za vsako možnost.
Sprejete vrste zvočnih datotek
- MP3
- M4A
- WAV
- OGG
- WEBM
- M4P
Sprejete vrste video datotek
- MP4
- M4V
- WMV
- AVI
- MOV
- FLV
Sprejete vrste besedilnih datotek
- TXT
- Wordov dokument
Uvozi CSV
Prenesete lahko tudi besedilne datoteke CSV ali zvočne in video datoteke. Več o nalaganju CSV in prenesite CSV-je, združljive s programom Speak, tukaj.
Z datotekami CSV lahko naložite vse od več deset videoposnetkov iz YouTuba do več tisoč podatkov iz intervjujev.
Javno dostopni naslovi URL
Medije lahko v program Speak naložite tudi prek javno dostopnega URL-ja.
Če je na koncu naslova URL na voljo končnica vrste datoteke, ne boste imeli težav z uvozom posnetka za samodejno prepisovanje in analizo.
URL-ji YouTuba
Govorjenje je združljivo z videoposnetki YouTube. Vse, kar morate storiti, je, da kopirate naslov URL videoposnetka YouTube (na primer, https://www.youtube.com/watch?v=qKfcLcHeivc).
Speak bo samodejno poiskal datoteko, izračunal dolžino in uvozil videoposnetek.
Če uporabljate videoposnetke YouTube, poskrbite, da uporabite celotno povezavo in ne skrajšanega odlomka iz YouTuba. Poleg tega iz naslova URL odstranite ime kanala.
Integracije govora
Kot smo že omenili, Speak vsebuje tudi vrsto integracij za Povečanje, Zapier, Vimeo in druge, ki vam bodo pomagali samodejno prepisovati medije.
Knjižnica integracij se še naprej širi! Imate zahtevo? Pošljite nam sporočilo.

Korak 3: Samodejno izračunajte in plačajte znesek
Once you have your file(s) ready and load it into Speak, it will automatically calculate the total cost (free credits are included in the 7-day trial – take advantage of them!).
Če v program Speak nalagate besedilne podatke, vam trenutno ni treba plačati nobenih stroškov. Le za analizo čarobnih namigov v programu Speak je treba plačati pristojbino, ki bo podrobneje opisana v nadaljevanju.
Once you use your trial credits or need Speak Magic Prompts, you can top up credits (1 credit = US$1) or subscribe to Pro at US$25 per user per month, or US$20 per user per month billed annually. See the stran s cenami za podrobnosti.
Prav tako lahko dodajanje ravnotežja ali plačati za prenos in analizo brez načrta z uporabo vašega kreditna kartica.

4. korak: Počakajte, da se oglasite in analizirate podatke iz akcijskih raziskav
Če nalagate zvočne in video posnetke, bo naša programska oprema za avtomatsko prepisovanje hitro pripravila prepis. Po zaključku boste prejeli e-poštno obvestilo, da je vaš prepis končan. To e-poštno sporočilo bo vsebovalo povezavo nazaj do datoteke, tako da boste lahko dostopali do interaktivnega medijskega predvajalnika s pripravljenimi oblikami zapisa, analize in izvoza.
Če uvažate datoteke CSV ali nalagate besedilne datoteke, bo Speak na splošno hitreje analiziral informacije.
Korak 5: Obiščite svojo datoteko ali mapo
Speak lahko analizira posamezne datoteke in celotne mape s podatki.
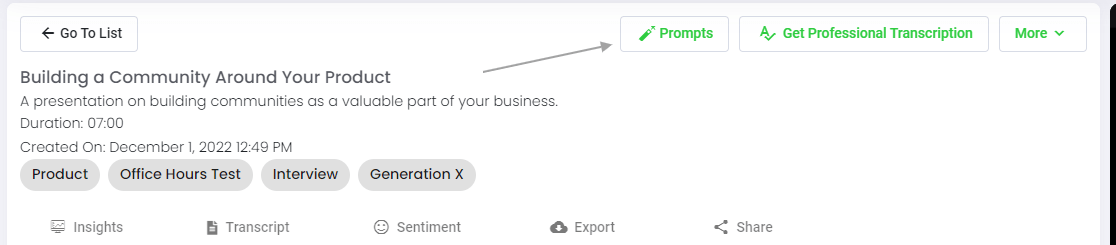
Ko pregledujete posamezno datoteko v programu Speak, morate klikniti na gumb "Pozivi".
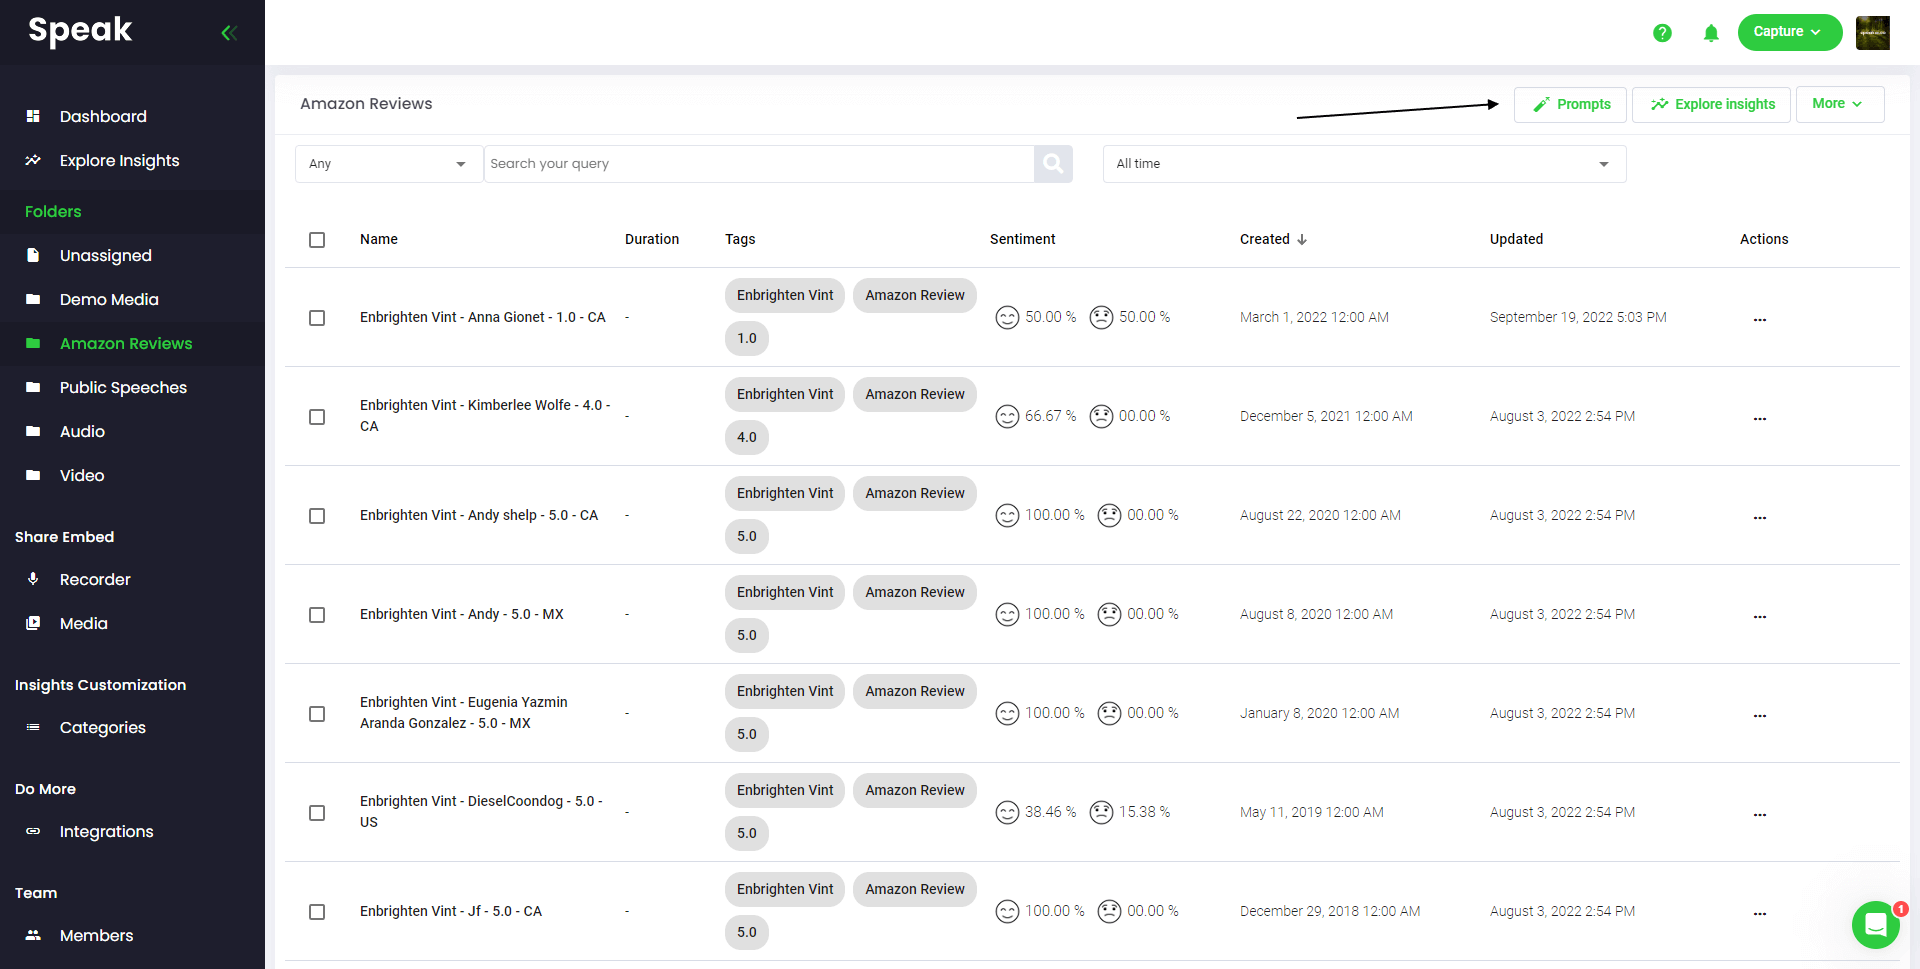
Če želite analizirati več datotek, morate datoteke, ki jih želite analizirati, dodati v mapo v programu Speak.
To lahko storite z dodajanjem novih datotek v mapo Speak ali pa trenutne datoteke uredite v želeno mapo z enostavno funkcijo urejanja v programu.
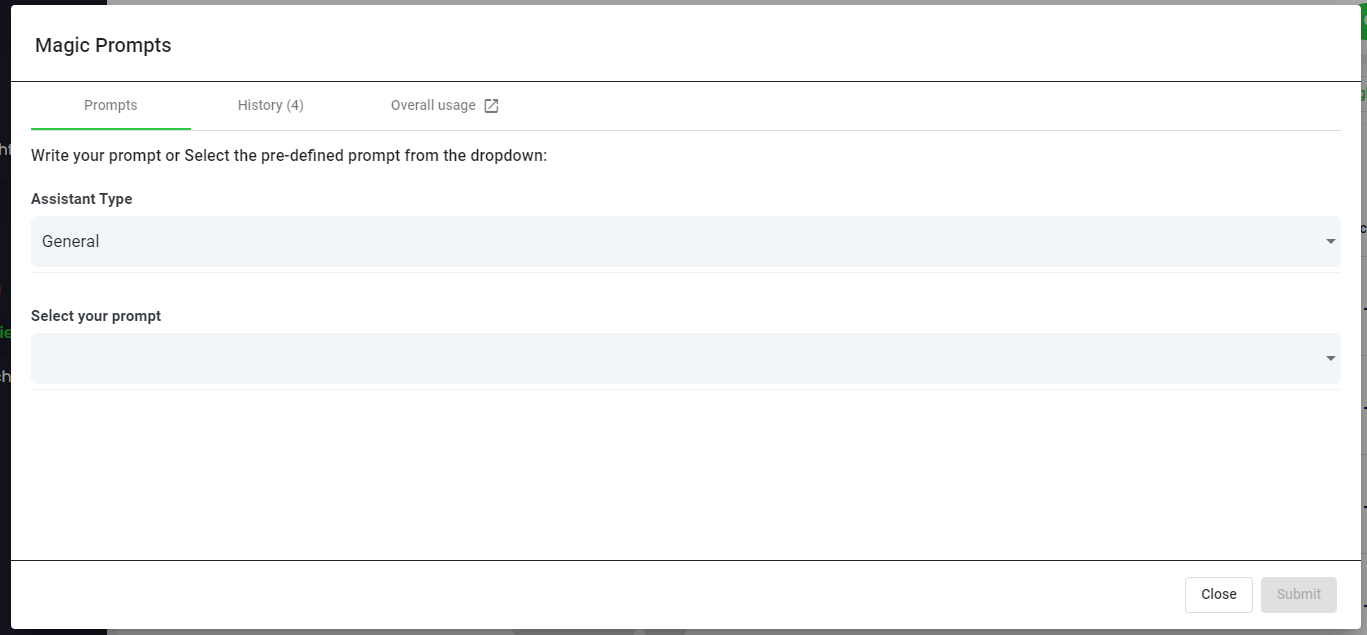
Korak 6: Izberite magične spodbude za analizo podatkov iz akcijskega raziskovanja
Kaj so čarobne spodbude?
Speak Magic Prompts uporablja inovacije na področju modelov umetne inteligence, ki se pogosto imenujejo "generativna umetna inteligenca".
Ti modeli so analizirali ogromne količine podatkov z vsega interneta, da bi razumeli jezik.
S tem razumevanjem so ti "veliki jezikovni modeli" sposobni opravljati naloge, ki presegajo možgane!
Z aplikacijo Speak Magic Prompts lahko zdaj opravljate ta opravila z zvočnimi, video in besedilnimi podatki v računu Speak.
Korak 7: Izberite vrsto asistenta
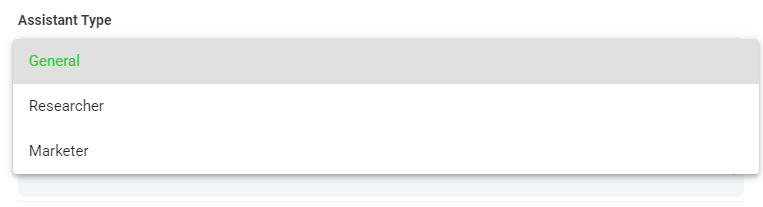
Da bi vam pomagal doseči boljše rezultate z magičnimi pozivi Speak, je Speak uvedel "Tip pomočnika".
Te vrste pomočnikov so vnaprej nastavljene in zagotavljajo kontekst mehanizmu za pozive za bolj jedrnate in smiselne izpise glede na vaše potrebe.
Za začetek smo vključili:
- Splošno
- Raziskovalec
- Tržnik
V spustnem oknu izberite najustreznejšo vrsto asistenta.
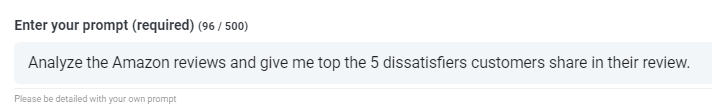
Korak 8: Ustvarite ali izberite želeni poziv
Tukaj je nekaj primerov pozivov, ki jih lahko zdaj uporabite za katero koli datoteko:
- Izdelava analize SWOT
- Navedite mi najpomembnejše akcijske elemente
- Ustvarite povzetek seznama s točkami
- Povejte mi ključna vprašanja, ki so ostala nerešena
- Povej mi, katera vprašanja so bila zastavljena
- Ustvarjanje lastnih pozivov po meri
Prikazal se bo modalni okno, v katerem lahko uporabite predlagane spodbude, ki smo jih delili zgoraj, in tako takoj in čarobno dobite odgovore.
Če želite ustvariti lastne pozive, v spustnem oknu izberite "Custom Prompt" in odprlo se bo drugo besedilno polje, v katerem lahko od svojih podatkov zahtevate karkoli želite!
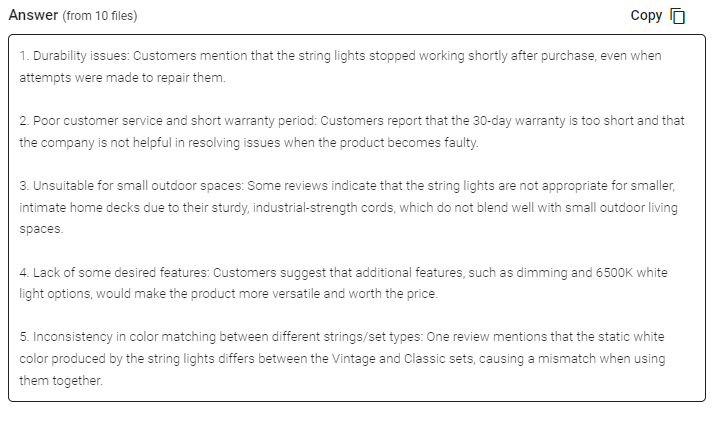
Korak 9: Pregled in deljenje odgovorov
V besedilnem polju pod spustno vrstico za izbiro pozivov se bo ustvaril kratek odgovor.
V tem primeru želimo analizirati vse podatke iz intervjujev v mapi naenkrat za največje nezadovoljneže z izdelki.
Ta odziv lahko preprosto kopirate za svoje predstavitve, vsebine, e-poštna sporočila, člane ekipe in še več!
Govorite čarobne namige kot ChatGPT za določanje cen podatkov akcijskih raziskav
Our team at Speak AI continues to optimize the pricing for Magic Prompts and Speak as a whole.
Trenutno je v 7-dnevni preizkusni različici storitve Speak v račun vključenih 100.000 znakov.
Če potrebujete več znakov, lahko ob ustvarjanju naročnine v svoj načrt preprosto vključite govorjenje čarobnih namigov.
Število znakov v računu lahko nadgradite tudi, če že imate naročnino.
Obe možnosti sta na voljo v stran za naročnino.
Uporabite lahko tudi program Speak Magic Prompts, ki ga dodajanje ravnotežja v svoj račun. Sredstva bodo porabljena za analizo znakov.
Popolnoma prilagodite svoj načrt 📝
V podjetju Speak smo poskrbeli, da je prilagajanje naročnine izjemno enostavno.
Ko se prijavite, obiščite našo graditelj načrtov po meri in izberite količino medijev, velikost ekipe in želene funkcije, da dobite načrt, ki ustreza vašim potrebam.
Nič več togih načrtov. Nadgradite, znižajte ali prekličite kadar koli.
Zahtevajte svojo posebno ponudbo 🎁
Ko se naročite, boste za tri mesece prejeli tudi brezplačen dodatek Premium!
To pomeni, da lahko prihranite do $50 USD na mesec in $150 USD skupaj.
Ko se naročite na načrt, nam morate le poslati sporočilo v klepetu v živo z izbranim premijskim dodatkom s spodnjega seznama:
- Premium možnosti izvoza (Word, CSV in druge)
- Kategorije po meri in vpogledi
- Množično urejanje in organizacija podatkov
- Prilagoditev snemalnika (blagovna znamka, vnos in drugo)
- Prilagajanje predvajalnika medijev
- Knjižnice medijev, ki jih je mogoče deliti
Dodatek bomo brezplačno prenesli v vaš račun!
Na kaj še čakate?
Napotite druge in zaslužite pravi denar 💸
Če imate prijatelje, vrstnike in sledilce, ki jih zanima uporaba naše platforme, lahko zaslužite pravi mesečni denar.
Prejeli boste odstotek vseh prodaj, ne glede na to, ali stranke, ki jih boste napotili, plačajo za načrt, samodejno prepisujejo medije ali uporabljajo profesionalne storitve prepisovanja.
Uporabite to povezavo da postanete uradni partner družbe Speak.
Oglejte si naše namenske vire📚
- Dokumenti za pomoč
- Dokumenti API
- Speak AI YouTube Channel
- Vodnik za izdelavo popolnega načrta govora
Rezervirajte brezplačno sejo za izvajanje 🤝
V čast bi mi bilo, če bi se lahko osebno udeležil uvodnega klica z vami in se prepričal, da ste pripravljeni na uspeh.
Uporabite naš Povezava do storitve Calendly in poiščite čas, ki vam ustreza. Veselimo se srečanja z vami!
Pogosto zastavljena vprašanja
What is the difference between Word2Vec and word embeddings?
Word embeddings are the general idea of representing words as dense numerical vectors. Word2Vec is one specific algorithm, introduced by Google researchers in 2013, that learns those vectors from large text collections.
How does Word2Vec work?
It trains a shallow neural network in one of two ways. CBOW predicts a word from its surrounding context, while Skip-gram predicts the surrounding words from a target word. The learned weights become the word vectors.
What are contextual word embeddings?
Contextual embeddings give the same word a different vector depending on its sentence. Models such as BERT and GPT do this, so bank in a river sentence differs from bank in a finance sentence. Word2Vec gives one fixed vector per word.
What is the difference between one-hot encoding and word embeddings?
One-hot encoding gives each word a long sparse vector with a single 1 and no sense of meaning. Embeddings are shorter dense vectors where words with similar meanings sit close together.
Analyze Text, Audio & Video with Speak AI
Speak AI provides AI-powered text, audio, and video analysis with NLP, sentiment analysis, keyword extraction, and theme detection. Built for researchers, analysts, and enterprise teams working with qualitative and quantitative data.
 English
 Español
 Français
 Italiano
 العربية
 Português do Brasil
 Nederlands
 Deutsch
 עִבְרִית
 Русский
 日本語
 Polski
 Čeština
 Українська
 Slovenščina
 Svenska
 Ελληνικά
 Norsk bokmål
 简体中文
 Türkçe
 Català
 Magyar
 한국어
 Slovenčina
 Suomi