
What is Word2vec and Word Embeddings?
Word2vec and Word Embeddings are two strategies of natural language processing (NLP). Word2vec is a two-layer neural network used to generate distributed representations of words called word embeddings, while word embeddings are a collection of numerical vectors (embeddings) that represent words. Word2vec is a deep learning algorithm that can learn the representations of words by scanning through large amounts of text or text corpora.
How do Word2vec and Word Embeddings Work?
Word2vec and Word Embeddings are based on the idea of distributed representation. This means that each word is represented as a vector of numbers instead of a single number. This allows for words to have similar meaning to have similar vectors. Word2vec uses a neural network to learn these representations, while word embeddings are learned from text corpora.
What are the Differences between Word2vec and Word Embeddings?
The primary difference between Word2vec and Word Embeddings is the way in which they are created. Word2vec is a machine learning algorithm that uses a deep neural network to learn the representations of words by scanning through large amounts of text. Word embeddings are created by analyzing the context of words in text corpora. Additionally, Word2vec is used to generate distributed representations of words, while word embeddings are a collection of numerical vectors.
Why Should You Use Word2vec and Word Embeddings?
Word2vec and Word Embeddings are important tools for natural language processing. They allow for words to be represented in a numerical form, which is useful for many NLP tasks such as text classification, sentiment analysis, and machine translation. Additionally, Word2vec and Word Embeddings can be used to better understand the context of words, which can be useful for many applications such as document summarization and question answering.
Slik bruker du de beste store språkmodellene for aksjonsforskning med Speak

Trinn 1: Opprett Speak-kontoen din
For å starte transkriberingen og analysen må du først opprette en Speak-konto. Ingen grunn til bekymring, dette er superenkelt å gjøre!
Get a 7-day trial with free credits for English audio and video transcription included when you sign up for Speak.
For å registrere deg for Speak og begynne å bruke Speak Magic Prompts, besøk Registreringsside for Speak-appen her.

Trinn 2: Last opp aksjonsforskningsdataene dine
I Speak kan du sømløst laste opp, transkribere og oversette lyd-, video- og tekstfiler på én gang! Hvis du har video, kan du bruke vår AI video-til-tekst-omformer for å konvertere video til tekst; hvis du har lyd, kan du bruke vår AI-lyd-til-tekst-omformer for å konvertere lyd til tekst. Du kan også transkribere YouTube-videoer og bruke kunstig intelligens til å analysere tekst. Du kan se kompatible filtyper for hvert alternativ nedenfor.
Godkjente lydfiltyper
- MP3
- M4A
- WAV
- OGG
- WEBM
- M4P
Godkjente videofiltyper
- MP4
- M4V
- WMV
- AVI
- MOV
- FLV
Godkjente tekstfiltyper
- TXT
- Word-dokument
CSV-import
Du kan også laste opp CSV-filer med tekstfiler eller lyd- og videofiler. Du kan lære mer om CSV-opplasting og Last ned Speak-kompatible CSV-filer her.
Med CSV-filene kan du laste opp alt fra dusinvis av YouTube-videoer til tusenvis av intervjudata.
Offentlig tilgjengelige nettadresser
Du kan også laste opp medier til Speak via en offentlig tilgjengelig URL.
Så lenge filtypenavnet er tilgjengelig på slutten av URL-en, er det ikke noe problem å importere opptaket for automatisk transkripsjon og analyse.
YouTube-nettadresser
Speak er kompatibel med YouTube-videoer. Alt du trenger å gjøre er å kopiere URL-en til YouTube-videoen (f.eks, https://www.youtube.com/watch?v=qKfcLcHeivc).
Speak finner filen automatisk, beregner lengden og importerer videoen.
Hvis du bruker YouTube-videoer, må du sørge for å bruke den fullstendige lenken og ikke den forkortede YouTube-snutten. I tillegg må du fjerne kanalnavnet fra URL-en.
Speak-integrasjoner
Som nevnt inneholder Speak også en rekke integrasjoner for Zoom, Zapier, Vimeo og flere som hjelper deg med å transkribere mediene dine automatisk.
Dette biblioteket med integrasjoner fortsetter å vokse! Har du en forespørsel? Send oss gjerne en melding.

Trinn 3: Beregn og betal summen automatisk
Once you have your file(s) ready and load it into Speak, it will automatically calculate the total cost (free credits are included in the 7-day trial – take advantage of them!).
Hvis du laster opp tekstdata til Speak, trenger du for øyeblikket ikke å betale noen kostnad. Det er bare analysen av Speak Magic Prompts som vil medføre en avgift, som beskrives nærmere nedenfor.
Once you use your trial credits or need Speak Magic Prompts, you can top up credits (1 credit = US$1) or subscribe to Pro at US$25 per user per month, or US$20 per user per month billed annually. See the prisingsside for detaljer.
Du kan også legge til en saldo eller betale for opplasting og analyse uten en plan ved hjelp av din kredittkort.

Trinn 4: Vent på at Speak analyserer aksjonsforskningsdataene dine
Hvis du laster opp lyd og video, vil den automatiserte transkripsjonsprogramvaren vår raskt utarbeide transkripsjonen din. Når du er ferdig, får du en e-postmelding om at transkripsjonen er fullført. E-posten inneholder en lenke tilbake til filen, slik at du kan få tilgang til den interaktive mediespilleren med transkripsjonen, analysen og eksportformatene klare for deg.
Hvis du importerer CSV-filer eller laster opp tekstfiler, vil Speak generelt analysere informasjonen mye raskere.
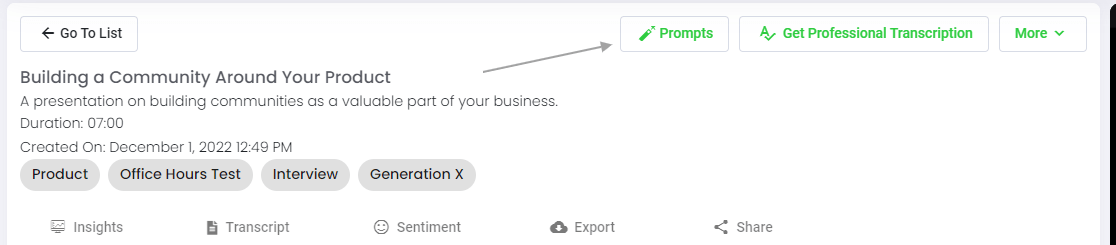
Trinn 5: Besøk filen eller mappen din
Speak kan analysere både enkeltfiler og hele mapper med data.
Når du ser på en enkelt fil i Speak, trenger du bare å klikke på "Prompts"-knappen.
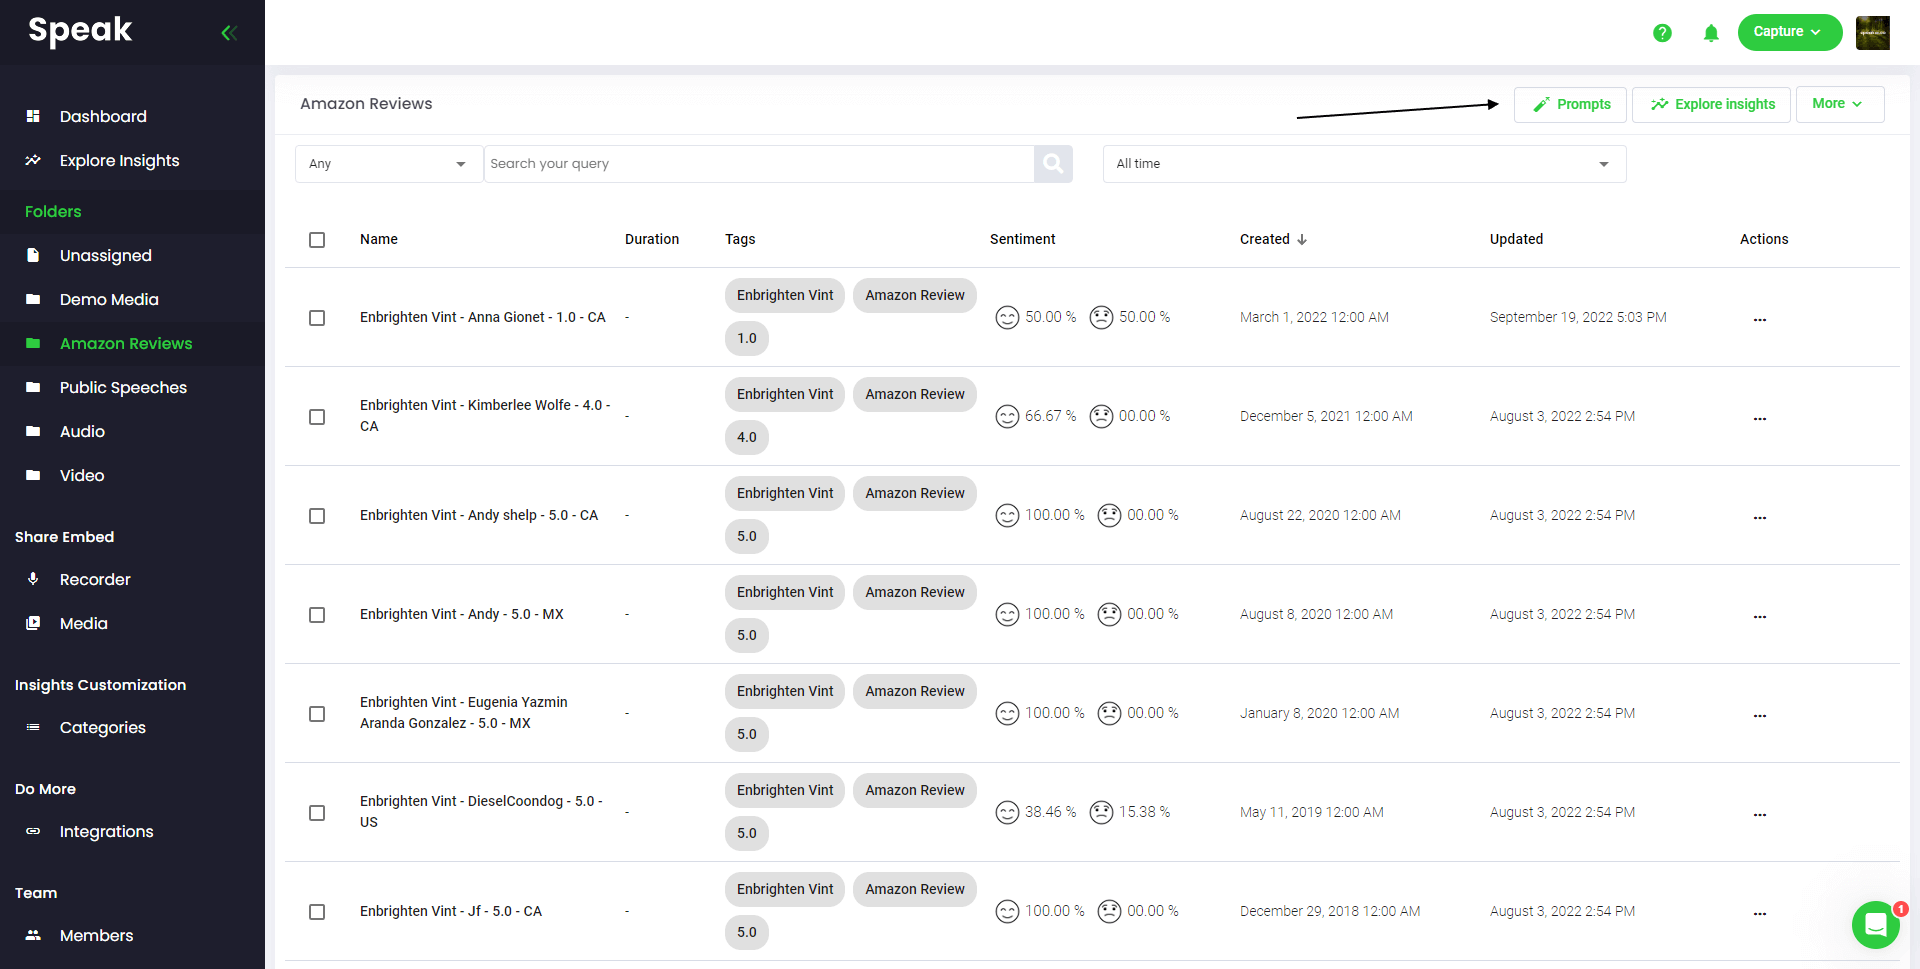
Hvis du vil analysere mange filer, trenger du bare å legge til filene du vil analysere, i en mappe i Speak.
Det kan du gjøre ved å legge til nye filer i Speak, eller du kan organisere dine nåværende filer i ønsket mappe ved hjelp av programvarens enkle redigeringsfunksjonalitet.
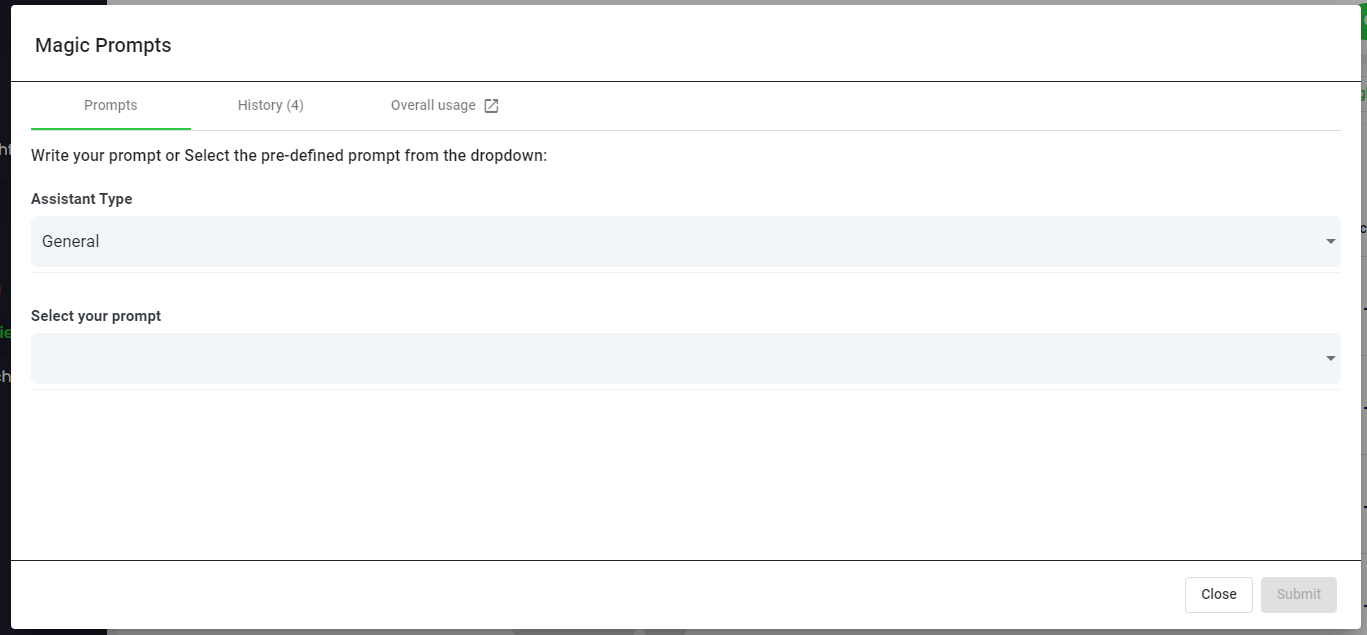
Trinn 6: Velg Speak Magic Prompts for å analysere aksjonsforskningsdataene dine
Hva er magiske ledetekster?
Speak Magic Prompts utnytter innovasjon innen kunstig intelligens, ofte omtalt som "generativ AI".
Disse modellene har analysert enorme mengder data fra internett for å få en forståelse av språket.
Med denne forståelsen er disse "store språkmodellene" i stand til å utføre halsbrekkende oppgaver!
Med Speak Magic Prompts kan du nå utføre disse oppgavene på lyd-, video- og tekstdataene i Speak-kontoen din.
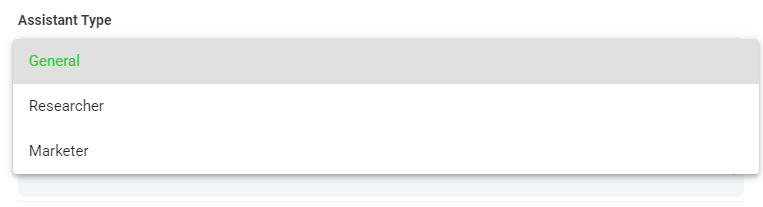
Trinn 7: Velg assistenttype
For å hjelpe deg med å få bedre resultater fra Speak Magic Prompts har Speak introdusert "Assistant Type".
Disse assistenttypene er forhåndsinnstilt og gir kontekst til spørremotoren, slik at du får mer konsise og meningsfulle utdata basert på dine behov.
Til å begynne med har vi inkludert:
- Generelt
- Forsker
- Markedsfører
Velg den mest relevante assistenttypen fra rullegardinmenyen.
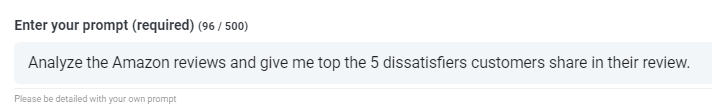
Trinn 8: Opprett eller velg ønsket ledetekst
Her er noen eksempler på instruksjoner som du kan bruke på en hvilken som helst fil akkurat nå:
- Lag en SWOT-analyse
- Gi meg de viktigste tiltakene
- Lag et sammendrag i form av en punktliste
- Fortell meg om de viktigste spørsmålene som ikke ble løst
- Fortell meg hvilke spørsmål som ble stilt
- Lag dine egne, tilpassede ledetekster
En modal vil dukke opp, slik at du kan bruke de foreslåtte spørsmålene vi delte ovenfor for å få svarene dine umiddelbart og på magisk vis.
Hvis du vil lage dine egne spørsmål, velger du "Egendefinert spørsmål" i rullegardinmenyen, og en ny tekstboks åpnes der du kan spørre om hva du vil om dataene dine!
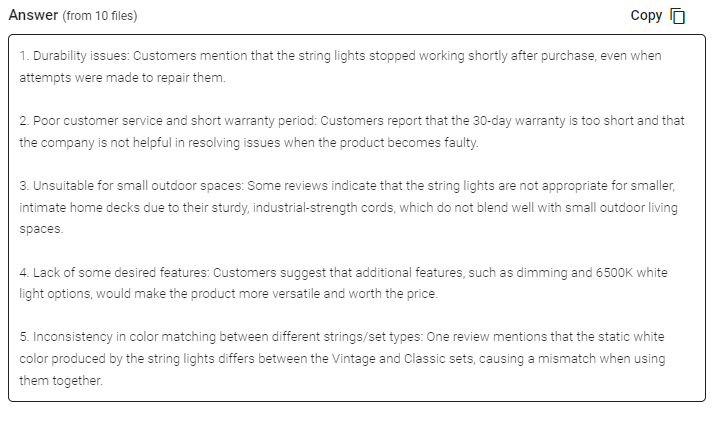
Trinn 9: Gjennomgå og del svarene
Speak genererer et kortfattet svar for deg i en tekstboks under rullegardinmenyen for valg av ledetekst.
I dette eksempelet ber vi om å analysere alle intervjudataene i mappen på én gang for å finne de mest misfornøyde produktene.
Du kan enkelt kopiere svaret til presentasjoner, innhold, e-poster, teammedlemmer og mye mer!
Speak Magic Prompts som ChatGPT for prising av aksjonsforskningsdata
Our team at Speak AI continues to optimize the pricing for Magic Prompts and Speak as a whole.
Akkurat nå får alle som er med i den 7-dagers prøveperioden av Speak, 100 000 tegn inkludert i kontoen sin.
Hvis du trenger flere tegn, kan du enkelt inkludere Speak Magic Prompts i abonnementet ditt når du oppretter et abonnement.
Du kan også oppgradere antall tegn på kontoen din hvis du allerede har et abonnement.
Begge alternativene er tilgjengelige på abonnementsside.
Alternativt kan du bruke Speak Magic Prompts ved å legge til en balanse til kontoen din. Saldoen vil bli brukt etter hvert som du analyserer tegn.
Tilpass planen din helt individuelt 📝
Her hos Speak har vi gjort det utrolig enkelt å tilpasse abonnementet ditt.
Når du har registrert deg, er det bare å besøke vår tilpasset planbygger og velg medievolum, teamstørrelse og funksjoner du ønsker for å få et abonnement som passer dine behov.
Ingen flere rigide planer. Du kan oppgradere, nedgradere eller kansellere når som helst.
Gjør krav på spesialtilbudet ditt 🎁
Når du abonnerer, får du også et gratis premium-tillegg i tre måneder!
Det betyr at du sparer opptil $50 USD per måned og $150 USD totalt.
Når du abonnerer på en plan, er alt du trenger å gjøre å sende oss en live chat med det valgte premiumtillegget fra listen nedenfor:
- Premium eksportalternativer (Word, CSV og mer)
- Egendefinerte kategorier og innsikt
- Masseredigering og organisering av data
- Tilpasning av opptakeren (merkevarebygging, inndata og mer)
- Tilpasning av mediespilleren
- Delbare mediebiblioteker
Vi vil sette tillegget live på kontoen din uten ekstra kostnad!
Hva venter du på?
Henvis andre og tjen ekte penger 💸
Hvis du har venner, kolleger og følgere som er interessert i å bruke plattformen vår, kan du tjene ekte månedlige penger.
Du får betalt en prosentandel av alt salg, enten kundene du henviser til å betale for et abonnement, transkribere medier automatisk eller benytte profesjonelle transkripsjonstjenester.
Bruk denne lenken for å bli en offisiell Speak-tilknyttet organisasjon.
Ta en titt på våre dedikerte ressurser📚.
Bestill en gratis implementeringstime 🤝
Det ville være en ære å ta en introduksjonssamtale med deg for å sikre at du er klar for suksess.
Bare bruk vår Lenke til Calendly for å finne et tidspunkt som passer deg. Vi ser frem til å møte deg!
Ofte stilte spørsmål
What is the difference between Word2Vec and word embeddings?
Word embeddings are the general idea of representing words as dense numerical vectors. Word2Vec is one specific algorithm, introduced by Google researchers in 2013, that learns those vectors from large text collections.
How does Word2Vec work?
It trains a shallow neural network in one of two ways. CBOW predicts a word from its surrounding context, while Skip-gram predicts the surrounding words from a target word. The learned weights become the word vectors.
What are contextual word embeddings?
Contextual embeddings give the same word a different vector depending on its sentence. Models such as BERT and GPT do this, so bank in a river sentence differs from bank in a finance sentence. Word2Vec gives one fixed vector per word.
What is the difference between one-hot encoding and word embeddings?
One-hot encoding gives each word a long sparse vector with a single 1 and no sense of meaning. Embeddings are shorter dense vectors where words with similar meanings sit close together.
Analyze Text, Audio & Video with Speak AI
Speak AI provides AI-powered text, audio, and video analysis with NLP, sentiment analysis, keyword extraction, and theme detection. Built for researchers, analysts, and enterprise teams working with qualitative and quantitative data.
 English
 Español
 Français
 Italiano
 العربية
 Português do Brasil
 Nederlands
 Deutsch
 עִבְרִית
 Русский
 日本語
 Polski
 Čeština
 Українська
 Slovenščina
 Svenska
 Ελληνικά
 Norsk bokmål
 简体中文
 Türkçe
 Català
 Magyar
 한국어
 Slovenčina
 Suomi