
What is Word2vec and Word Embeddings?
Word2vec and Word Embeddings are two strategies of natural language processing (NLP). Word2vec is a two-layer neural network used to generate distributed representations of words called word embeddings, while word embeddings are a collection of numerical vectors (embeddings) that represent words. Word2vec is a deep learning algorithm that can learn the representations of words by scanning through large amounts of text or text corpora.
How do Word2vec and Word Embeddings Work?
Word2vec and Word Embeddings are based on the idea of distributed representation. This means that each word is represented as a vector of numbers instead of a single number. This allows for words to have similar meaning to have similar vectors. Word2vec uses a neural network to learn these representations, while word embeddings are learned from text corpora.
What are the Differences between Word2vec and Word Embeddings?
The primary difference between Word2vec and Word Embeddings is the way in which they are created. Word2vec is a machine learning algorithm that uses a deep neural network to learn the representations of words by scanning through large amounts of text. Word embeddings are created by analyzing the context of words in text corpora. Additionally, Word2vec is used to generate distributed representations of words, while word embeddings are a collection of numerical vectors.
Why Should You Use Word2vec and Word Embeddings?
Word2vec and Word Embeddings are important tools for natural language processing. They allow for words to be represented in a numerical form, which is useful for many NLP tasks such as text classification, sentiment analysis, and machine translation. Additionally, Word2vec and Word Embeddings can be used to better understand the context of words, which can be useful for many applications such as document summarization and question answering.
כיצד להשתמש במודלים הטובים ביותר של שפה גדולה למחקר פעולה עם Speak

שלב 1: צור את חשבון Speak שלך
כדי להתחיל את התמלול והניתוח שלך, תחילה עליך לעשות זאת צור חשבון Speak. אל דאגה, זה סופר קל לעשות!
Get a 7-day trial with free credits for English audio and video transcription included when you sign up for Speak.
כדי להירשם ל-Speak ולהתחיל להשתמש ב-Speak Magic Prompts, בקר באתר דבר דף הרשמה לאפליקציה כאן.

שלב 2: העלה את נתוני מחקר הפעולה שלך
ב-Speak, אתה יכול להעלות, לתמלל ולתרגם בצורה חלקה קבצי אודיו, וידאו וטקסט בבת אחת! אם יש לך וידאו, אתה יכול להשתמש שלנו ממיר וידאו לטקסט בינה מלאכותית כדי להמיר וידאו לטקסט; אם יש לך אודיו, אתה יכול להשתמש שלנו ממיר AI אודיו לטקסט כדי להמיר אודיו לטקסט. אתה יכול גם לתמלל סרטוני YouTube ו השתמש ב-AI כדי לנתח טקסט. תוכל לראות סוגי קבצים תואמים עבור כל אפשרות למטה.
סוגי קבצי אודיו מקובלים
- MP3
- M4A
- WAV
- OGG
- WEBM
- M4P
סוגי קבצי וידאו מקובלים
- MP4
- M4V
- WMV
- AVI
- MOV
- FLV
סוגי קבצי טקסט מקובלים
- TXT
- Word Doc
יבוא CSV
אתה יכול גם להעלות קובצי CSV של קבצי טקסט או קובצי אודיו ווידאו. תוכל ללמוד עוד על העלאות CSV ו הורד כאן קובצי CSV תואמי Speak.
עם קבצי ה-CSV, אתה יכול להעלות כל דבר, החל מעשרות סרטוני YouTube ועד לאלפי נתוני ראיונות.
כתובות URL זמינות לציבור
אתה יכול גם להעלות מדיה ל-Speak דרך כתובת אתר זמינה לציבור.
כל עוד סיומת סוג הקובץ זמינה בסוף כתובת האתר לא תהיה לך בעיה לייבא את ההקלטה שלך לתמלול וניתוח אוטומטי.
כתובות אתרים של YouTube
Speak תואם לסרטוני YouTube. כל שעליך לעשות הוא להעתיק את כתובת האתר של סרטון YouTube (לדוגמה, https://www.youtube.com/watch?v=qKfcLcHeivc).
Speak ימצא אוטומטית את הקובץ, יחשב את האורך וייבא את הסרטון.
אם אתה משתמש בסרטוני YouTube, אנא ודא שאתה משתמש בקישור המלא ולא בקטע YouTube המקוצר. בנוסף, הקפד להסיר את שם הערוץ מכתובת האתר.
דבר אינטגרציות
כאמור, Speak מכיל גם מגוון אינטגרציות עבור זום, זאפייר, Vimeo ועוד שיעזרו לך לתמלל את המדיה שלך באופן אוטומטי.
ספריית האינטגרציות הזו ממשיכה לגדול! יש לך בקשה? תרגישו מעודדים לשלוח לנו הודעה.

שלב 3: חשב ושלם את הסכום באופן אוטומטי
Once you have your file(s) ready and load it into Speak, it will automatically calculate the total cost (free credits are included in the 7-day trial – take advantage of them!).
אם אתה מעלה נתוני טקסט ל-Speak, אינך צריך כרגע לשלם כל עלות. רק הניתוח של Speak Magic Prompts ייצור עמלה שתפורט להלן.
Once you use your trial credits or need Speak Magic Prompts, you can top up credits (1 credit = US$1) or subscribe to Pro at US$25 per user per month, or US$20 per user per month billed annually. See the עמוד תמחור לפרטים.
אתה יכול גם להוסיף איזון או לשלם עבור העלאות וניתוח ללא תוכנית באמצעות שלך כרטיס אשראי.

שלב 4: המתן ל-Speak כדי לנתח את נתוני מחקר הפעולה שלך
אם אתה מעלה אודיו ווידאו, תוכנת התמלול האוטומטית שלנו תכין את התמליל שלך במהירות. לאחר השלמתו, תקבל הודעת דוא"ל שהתמליל שלך הושלם. דוא"ל זה יכיל קישור חזרה לקובץ כדי שתוכל לגשת לנגן המדיה האינטראקטיבי עם פורמטי התמלול, הניתוח והייצוא מוכנים עבורך.
אם אתה מייבא קובצי CSV או מעלה קבצי טקסט, Speak בדרך כלל ינתח את המידע הרבה יותר מהר.
שלב 5: בקר בקובץ או בתיקייה שלך
Speak מסוגל לנתח גם קבצים בודדים וגם תיקיות נתונים שלמות.
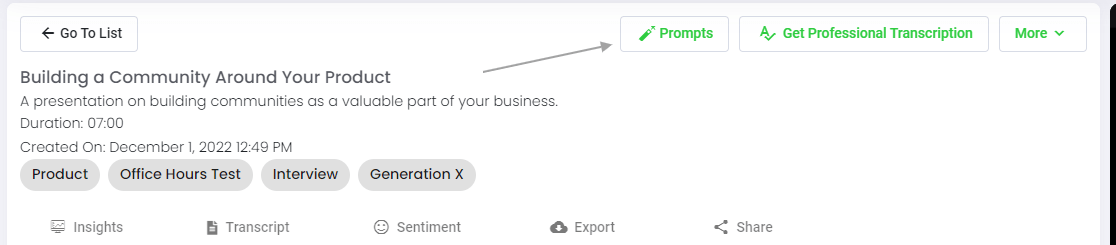
כאשר אתה צופה בכל קובץ בודד ב-Speak, כל מה שאתה צריך לעשות הוא ללחוץ על כפתור "הנחיות".
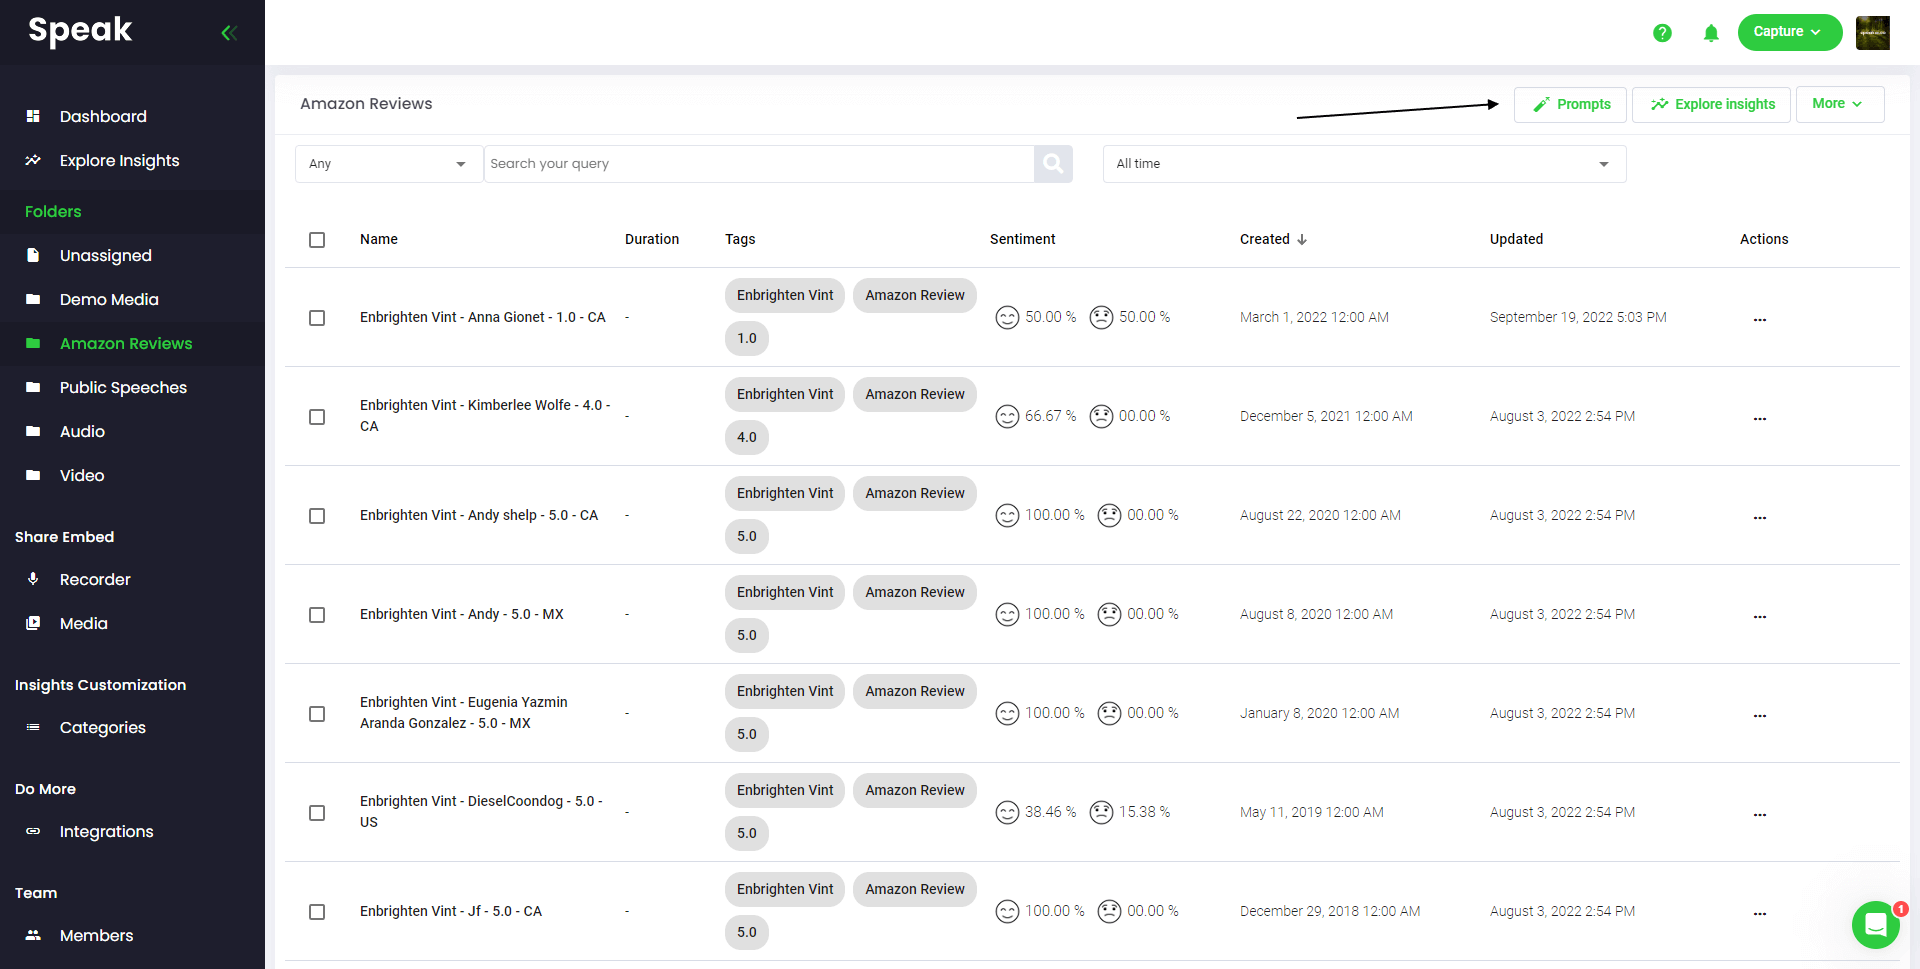
אם אתה רוצה לנתח קבצים רבים, כל מה שאתה צריך לעשות הוא להוסיף את הקבצים שאתה רוצה לנתח לתיקיה בתוך Speak.
אתה יכול לעשות זאת על ידי הוספת קבצים חדשים לתוך Speak או שאתה יכול לארגן את הקבצים הנוכחיים שלך בתיקייה הרצויה שלך עם פונקציונליות העריכה הקלה של התוכנה.
שלב 6: בחר דיבור הנחיות קסם כדי לנתח את נתוני מחקר הפעולה שלך
מהן הנחיות קסם?
Speak Magic Prompts ממנפים חדשנות במודלים של בינה מלאכותית המכונים לעתים קרובות "AI מחולל".
מודלים אלה ניתחו כמויות אדירות של נתונים מרחבי האינטרנט כדי להבין את השפה.
עם ההבנה הזו, "דגמי השפה הגדולים" הללו מסוגלים לבצע משימות מכופפות תודעה!
עם Speak Magic Prompts, כעת תוכל לבצע את המשימות הללו בנתוני השמע, הווידאו והטקסט בחשבון Speak שלך.
שלב 7: בחר את סוג העוזר שלך
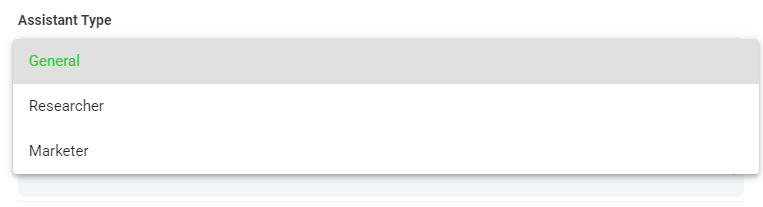
כדי לעזור לך לקבל תוצאות טובות יותר מ-Speak Magic Prompts, Speak הציגה את "סוג עוזר".
סוגי עוזרים אלו מוגדרים מראש ומספקים הקשר למנוע המהיר לקבלת תפוקות תמציתית ומשמעותית יותר בהתבסס על הצרכים שלך.
כדי להתחיל, כללנו:
- כְּלָלִי
- חוֹקֵר
- משווק
בחר את סוג העוזר הרלוונטי ביותר מהתפריט הנפתח.
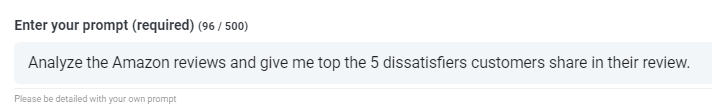
שלב 8: צור או בחר את ההנחיה הרצויה שלך
להלן כמה דוגמאות להנחיות שתוכל להחיל על כל קובץ כעת:
- צור ניתוח SWOT
- תן לי את פריטי הפעולה המובילים
- צור סיכום רשימת תבליטים
- ספר לי את הבעיות המרכזיות שנותרו ללא פתרון
- ספר לי אילו שאלות נשאלו
- צור הנחיות מותאמות אישית משלך
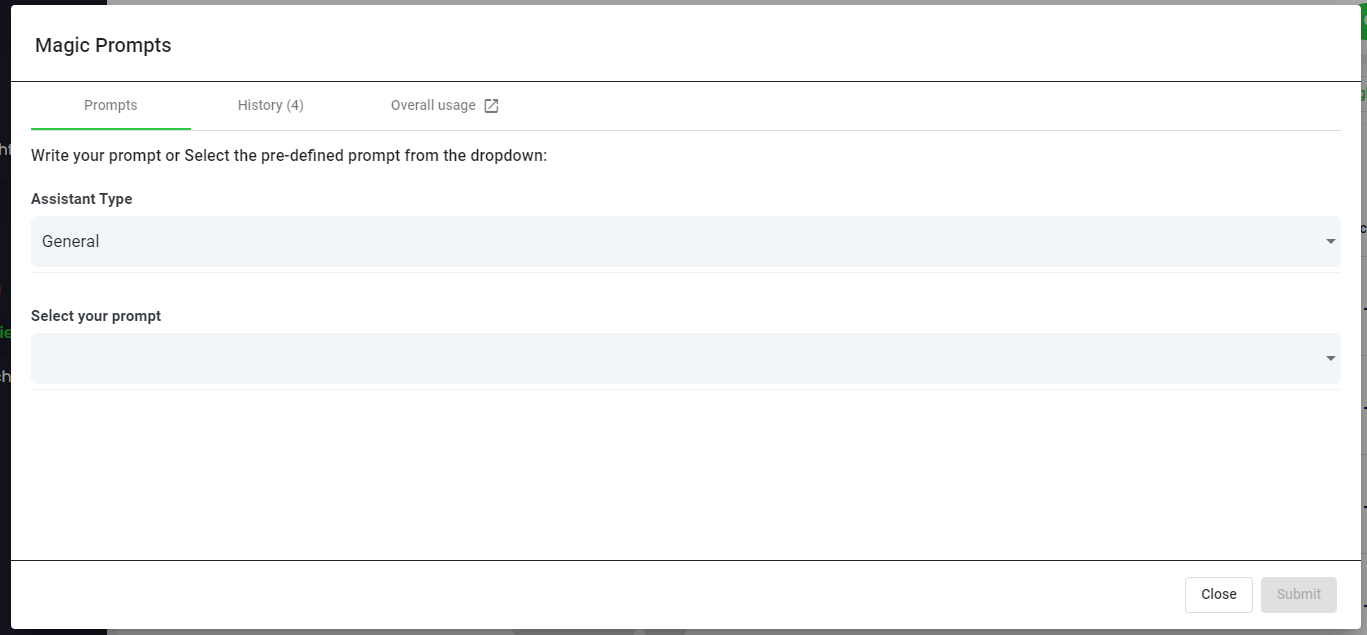
מודאל יופיע כך שתוכל להשתמש בהנחיות המוצעות שחלקנו למעלה כדי לקבל באופן מיידי ובקסם את התשובות שלך.
אם יש לך הנחיות משלך שברצונך ליצור, בחר "בקשה מותאמת אישית" מהתפריט הנפתח ותיבת טקסט נוספת תיפתח בה תוכל לשאול כל דבר שתרצה מהנתונים שלך!
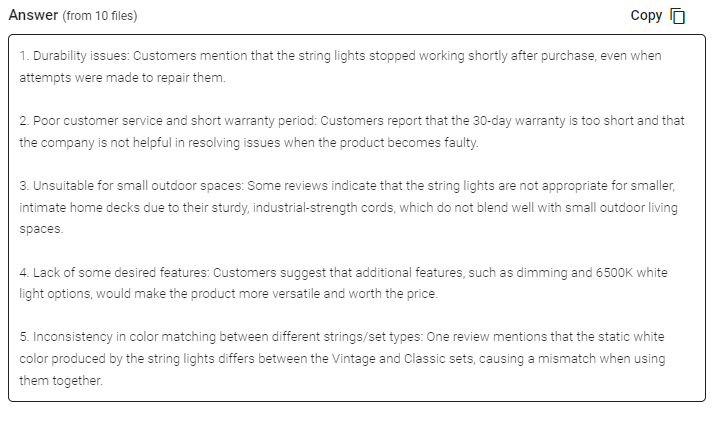
שלב 9: סקור ושתף תגובות
Speak תיצור עבורך תגובה תמציתית בתיבת טקסט מתחת לתפריט הנפתח של הבחירה.
בדוגמה זו, אנו מבקשים לנתח את כל נתוני הראיונות בתיקייה בבת אחת עבור מי שמסתפקים במוצר המוביל.
אתה יכול בקלות להעתיק את התגובה הזו למצגות, לתוכן, למיילים, לחברי צוות ועוד!
דברו הנחיות קסם כ-ChatGPT לתמחור נתוני מחקר פעולה
Our team at Speak AI continues to optimize the pricing for Magic Prompts and Speak as a whole.
כרגע, כל מי שנמצא ב-7 ימי הניסיון של Speak מקבל 100,000 תווים כלולים בחשבון שלו.
אם אתה צריך עוד דמויות, אתה יכול בקלות לכלול Speak Magic Prompts בתוכנית שלך כשאתה יוצר מנוי.
אתה יכול גם לשדרג את מספר התווים בחשבון שלך אם כבר יש לך מנוי.
שתי האפשרויות זמינות ב- עמוד מנוי.
לחלופין, אתה יכול להשתמש ב-Speak Magic Prompts by הוספת איזון לחשבון שלך. היתרה תשמש בעת ניתוח דמויות.
התאמה אישית לחלוטין של התוכנית שלך 📝
כאן ב-Speak, הפכנו את זה קל להפליא להתאים אישית את המנוי שלך.
לאחר ההרשמה, פשוט בקר שלנו בונה תוכניות בהתאמה אישית ובחר את נפח המדיה, גודל הצוות והתכונות שאתה רוצה כדי לקבל תוכנית שמתאימה לצרכים שלך.
אין יותר תוכניות נוקשות. שדרג, שדרג לאחור או בטל בכל עת.
קבל את ההצעה המיוחדת שלך 🎁
כשתירשמו, תקבלו גם תוספת פרימיום בחינם למשך שלושה חודשים!
זה אומר שאתה חוסך עד $50 דולר לחודש ו-$150 דולר בסך הכל.
לאחר שתירשם לתוכנית, כל מה שאתה צריך לעשות הוא לשלוח לנו צ'אט חי עם תוסף הפרימיום שבחרת מהרשימה למטה:
- אפשרויות ייצוא פרימיום (Word, CSV ועוד)
- קטגוריות ותובנות מותאמות אישית
- עריכה בכמות גדולה וארגון נתונים
- התאמה אישית של מקליט (מיתוג, קלט ועוד)
- התאמה אישית של נגן מדיה
- ספריות מדיה שניתנות לשיתוף
אנו נכניס את התוסף לפעיל בחשבונך ללא תשלום!
למה אתה מחכה?
הפנה אחרים והרוויח כסף אמיתי 💸
אם יש לך חברים, עמיתים ועוקבים המעוניינים להשתמש בפלטפורמה שלנו, אתה יכול להרוויח כסף חודשי אמיתי.
תקבלו תשלום באחוז מכלל המכירות בין אם הלקוחות שאליהם אתם מפנים משלמים עבור תוכנית, מתמללים מדיה אוטומטית או ממנפים שירותי תמלול מקצועיים.
השתמש בקישור הזה להפוך לשותף רשמי של Speak.
בדוק את המשאבים הייעודיים שלנו📚
הזמינו פגישת יישום בחינם 🤝
יהיה זה כבוד לקפוץ איתך באופן אישי לשיחת היכרות כדי לוודא שאתה מוכן להצלחה.
פשוט תשתמש שלנו קישור קלנדלי כדי למצוא זמן שמתאים לך. נשמח לפגוש אותך!
שאלות נפוצות
What is the difference between Word2Vec and word embeddings?
Word embeddings are the general idea of representing words as dense numerical vectors. Word2Vec is one specific algorithm, introduced by Google researchers in 2013, that learns those vectors from large text collections.
How does Word2Vec work?
It trains a shallow neural network in one of two ways. CBOW predicts a word from its surrounding context, while Skip-gram predicts the surrounding words from a target word. The learned weights become the word vectors.
What are contextual word embeddings?
Contextual embeddings give the same word a different vector depending on its sentence. Models such as BERT and GPT do this, so bank in a river sentence differs from bank in a finance sentence. Word2Vec gives one fixed vector per word.
What is the difference between one-hot encoding and word embeddings?
One-hot encoding gives each word a long sparse vector with a single 1 and no sense of meaning. Embeddings are shorter dense vectors where words with similar meanings sit close together.
נתח טקסט, אודיו וידאו עם Speak AI
Speak AI מספקת ניתוח טקסט, אודיו וווידאו מופעל בכוח AI עם NLP, ניתוח סנטימנט, חילוץ מילות מפתח וגילוי תמה. בנוי עבור חוקרים, אנליסטים וצוותי ארגון העובדים עם נתונים איכותיים וכמותיים.
 English
 Español
 Français
 Italiano
 العربية
 Português do Brasil
 Nederlands
 Deutsch
 עִבְרִית
 Русский
 日本語
 Polski
 Čeština
 Українська
 Slovenščina
 Svenska
 Ελληνικά
 Norsk bokmål
 简体中文
 Türkçe
 Català
 Magyar
 한국어
 Slovenčina
 Suomi